Kimi K3.1 Pro 发布时给了一张 14 格的总览图,看上去六项第一、全面领先。但这张图的读数规则比排名复杂得多:有的项带工具跑,有的用 pass@5,有的是自家出的题,还有两项已经饱和。
结论先行:Kimi 是目前最强的开源编码 agent,14 项全胜 DeepSeek、10 项全胜 GLM;但它强在"长程 + 命令行 + 专业文档",弱在"科研终端 + GUI 操作"。下面逐项说清楚每项在考什么、差距具体落在哪一步。
三步判断一个跑分能不能信 链接到标题
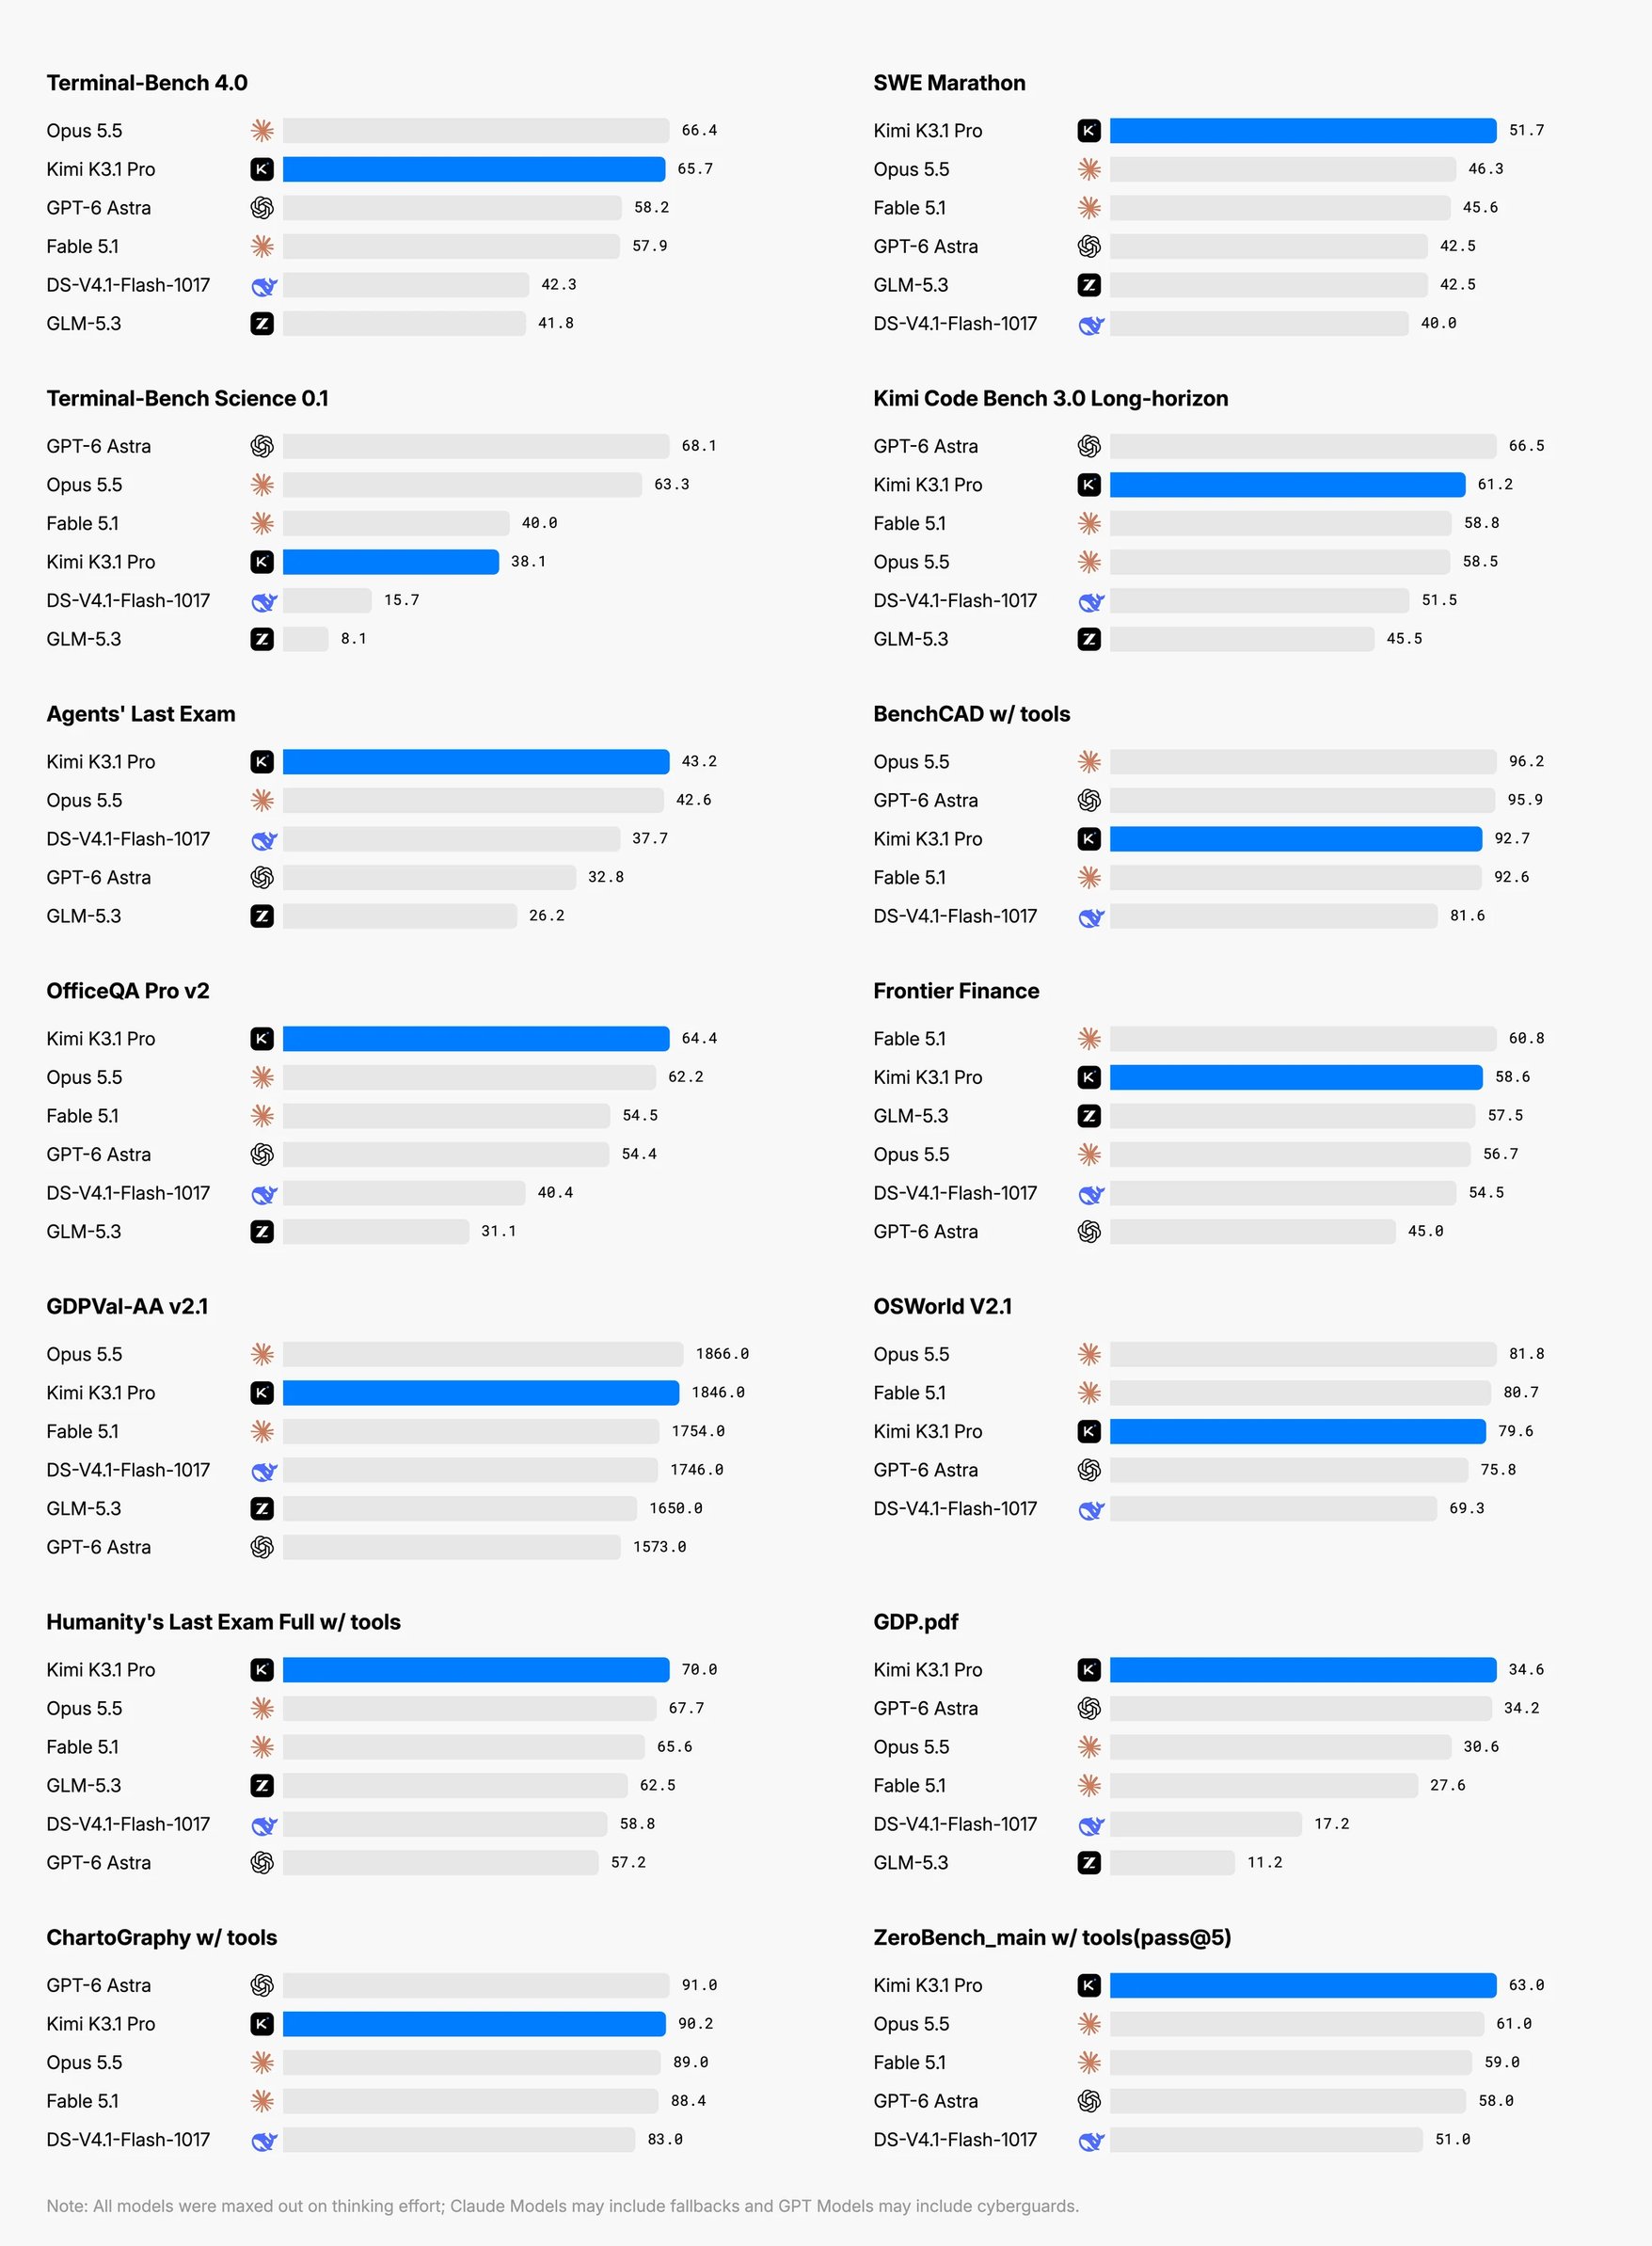
还有一处不对等要留神:官方脚注写着 Claude models may include fallbacks and GPT models may include cyberguards——对手可能走了降级路径或被安全策略拦截。65.7 对 66.4 这种贴身比较,最好别当胜负。
14 项一览 链接到标题
DS 为 DeepSeek-V4.1-Flash-1017(轻量版),GLM 为 GLM-5.3。“领先"是 Kimi 减去该模型的分差。
| 基准 | 考什么 | Kimi | DS | GLM | 领先 | 可信度 |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 终端真实工程任务 | 65.7 | 42.3 | 41.8 | +23 / +24 | ★★★★★ |
| SWE Marathon | 长程 issue→PR | 51.7 | 40.0 | 42.5 | +12 / +9 | ★★★★★ |
| TB Science 0.1 | 科研计算终端任务 | 38.1 | 15.7 | 8.1 | +22 / +30 | ★★★☆ |
| OSWorld V2.1 | GUI 跨应用操作 | 79.6 | 69.3 | — | +10 | ★★★★★ |
| Agents’ Last Exam | 122 个专家级任务 | 43.2 | 37.7 | 26.2 | +5.5 / +17 | ★★★★ |
| OfficeQA Pro v2 | 图像化财报问答 | 64.4 | 49.4 | 31.1 | +15 / +33 | ★★★★ |
| GDP.pdf | 专业 PDF 难题 | 34.6 | 17.2 | 11.2 | +17 / +23 | ★★★ |
| GDPval-AA | 真实职业交付物 | 1846 | 1746 | 1650 | +100 / +196 Elo | ★★★★ |
| Frontier Finance | 投资工作流 | 58.6 | 54.5 | 57.5 | +4 / +1 | ★★★ |
| BenchCAD (tools) | 图→CAD 代码 | 92.7 | 81.6 | — | +11 | ★★★ |
| ChartoGraphy (tools) | 专业图表理解 | 98.2 | 83.0 | — | +15 | ★★ |
| ZeroBench (pass@5) | 视觉难题 + 工具 | 63.0 | 51.0 | — | +12 | ★ |
| HLE Full (tools) | 跨学科难题 | 78.0 | 58.8 | 62.5 | +19 / +16 | ★★ |
| Kimi Code Bench 3.0 | 自家长程编程 | 61.2 | 51.5 | 45.5 | +10 / +16 | ★★ |
14 项全胜 DS,10 项全胜 GLM,没有一项被反超。 对 DS 平均领先 13.6 分,对 GLM 平均领先 18.8 分。
领先幅度长什么样 链接到标题
差距最大的是终端、科研终端、专业文档;最小的是金融工作流和泛化 agent。开源同行在高频工作流上正在快速收敛,Kimi 的优势集中在"长程耐力”。
一、编程与终端:差距在"能不能撑住几十步" 链接到标题
Terminal-Bench 4.0|65.7 ★★★★★ 链接到标题
考什么:Docker 容器里给你一台裸机和一个需求,自己装依赖、改代码、跑测试、修报错,最后由任务自带的隐藏测试判定。它不看解释写得好不好,只看东西跑不跑得通。
差距在哪:Kimi 65.7 与 Opus 66.4 只差 0.7,等于打平;真正拉开的是开源一侧——DS 42.3、GLM 41.8,落后 23 分以上,65.7 是 DS 的 1.55 倍。
有意思的是,这个差距不在"会不会写代码"上。多数失败是任务进行到二三十步时,模型"以为自己成功了"——没跑验证、没读报错、把一次偶然通过当成修好了。所以这一项实际考的是自我验证的纪律性,而 RL 训练的正是这个:让模型学会在宣布完成之前先怀疑自己。
SWE Marathon|51.7 ★★★★★ 链接到标题
考什么:长程软件工程。给一个真实仓库的 issue,要求跨多个文件、经过很多轮修改,最终产出一个能合并的 PR。考的不是单点修改,而是"撑不撑得住长时间不跑偏"。
差距在哪:Kimi 51.7 排第一,把 Opus(46.3)超了 5.4 分,DS 40.0、GLM 42.5。
这一项最能体现"耐力可以靠后训练补"。Kimi 与 Opus 的差距,本质是长上下文里的目标保持:任务越往后,早期读到的约束越容易被遗忘,模型开始改一些没人要求的东西。另外注意 GLM 在这里反超 DS(42.5 对 40.0),说明智谱在长任务的步骤调度上更稳。
TB Science 0.1|38.1 ★★★☆ 链接到标题
考什么:科研场景的终端任务——科学计算、数据处理、复现实验流程。同样是命令行,但要求懂单位、符号、数值库和学科惯例。
差距在哪:GPT-6 Astra 68.1、Opus 63.3,而 Kimi 只有 38.1,落后近 30 分,也只比 Fable(40.0)低一点;开源另外两家塌得更狠——DS 15.7、GLM 8.1。
这是全图最刺眼的短板,但别理解成"Kimi 不会做科研"。原因是这类任务的环境和 reward 都太少:科学计算缺少可自动判定的沙箱,RL 里几乎没有对应信号,模型只能靠通用推理硬扛。开源三家集体塌方(8 到 38 分)说明这是数据问题,不是某一家的问题。GLM 8.1 基本等于不会做。
Agents’ Last Exam|43.2 ★★★★ 链接到标题
考什么:伯克利 RDI 的 122 个专家级真实工作任务,其中 86 个要在命令行完成。环境镜像与官方发布对齐,并且明确对"上网抄答案"记 0 分。
差距在哪:Kimi 43.2、Opus 42.6,只差 0.6,算打平;DS 37.7、GLM 26.2。
这是 Kimi 对 DS 优势最小的一项(+5.5)。原因在于任务设计:122 个任务覆盖十几个领域,单个任务的深度有限,更吃"通用 agent 素养"而不是垂类专精。DS 37.7 甚至反超了 GPT-6 Astra(32.8),说明后者在 CLI 类任务上适配得不好。122 题的样本量也意味着这些差距大多落在噪声里。
Kimi Code Bench 3.0|61.2 ★★ 链接到标题
考什么:Kimi 内部的长程编程基准,多步执行、工具使用、端到端解题。题目不公开。
差距在哪:GPT-6 Astra 66.5 第一,Kimi 61.2 第二,DS 51.5、GLM 45.5。
自家榜上自己只排第二,这一点反而给整篇博客加了可信度。但要注意:DS 51.5 已经咬到 Opus(58.5)附近,说明它的长程执行被普遍低估了——毕竟它只是 Flash 轻量版。
二、操作与 3D:差距在"像素级试错" 链接到标题
OSWorld V2.1|79.6 ★★★★★ 链接到标题
考什么:真实操作系统的 GUI 里完成任务——开浏览器、点菜单、在多个窗口之间搬数据。逐步执行验证,是 computer-use 最标准的考场。
差距在哪:Fable 88.4、Opus 81.8、Kimi 79.6、GPT-6 Astra 75.8、DS 69.3。
Kimi 落后 Fable 8.8 分。这一项考的是像素级定位和试错恢复:模型看到的是截图,要靠理解坐标去点击,点偏一次就可能进错页面,还得自己发现并退回。闭源在这上面有大量人工标注的 GUI 轨迹,开源普遍停在 70 分上下——DS 69.3 和 Kimi 79.6 之间那 10 分,买的就是这部分数据。
BenchCAD|92.7 ★★★ 链接到标题
考什么:给多视角渲染图,生成 CAD 代码把 3D 模型重建出来,按 Voxel IoU 打分。1000 案子集。
差距在哪:Opus 96.2、GPT-6 Astra 95.9、Kimi 92.7、Fable 92.6,DS 81.6。
带工具时比的是"会不会调 CAD 库、能不能迭代渲染比对",Claude Code 脚手架贡献不小。真正有信息量的是不带工具那一栏:Kimi 72.8、Opus 73.0,基本持平。也就是说纯空间推理已经追平,差的只是工具链打磨。DS 81.6 落后 11 分,差在生成代码的几何正确率——它能把形状想对,但写出来的参数经常对不上。
三、专业文档:差距在"边缘 case" 链接到标题
OfficeQA Pro v2|64.4 ★★★★ 链接到标题
考什么:真实财政文档上的检索、跨文档核对、多步数值推理。关键设定是所有 PDF 都渲染成图片、不提供可读文本,所以它同时考视觉读数和算术。
差距在哪:Kimi 64.4 第一,Opus 62.2,Fable 54.5、GPT-6 Astra 54.4,DS 49.4、GLM 31.1。
GLM 只有 Kimi 的一半,是它全图最差的项之一。原因很具体:这类任务里,读错一个数字会沿着后续所有计算放大,而图像化表格恰恰最容易读错——跨页的表、合并单元格、脚注里的单位换算。GLM 在"图像化表格 + 长链条计算"这个组合上明显偏弱。
GDP.pdf|34.6 ★★★ 链接到标题
考什么:十个行业的在职专业人士出题,规则很狠——只有至少两个前沿模型"实质性答错"的题才被保留(答错、漏关键证据、编造都算)。覆盖文本溯源、表格图表、交叉引用、空间推理、以及对无依据问题拒答。
差距在哪:Opus 38.6、Kimi 34.6、GPT-6 Astra 34.2、Fable 27.6、DS 17.2、GLM 11.2。
因为题目本身就是"前沿模型都会翻车"的集合,考的全是边缘 case:错位的表格、被修订覆盖的条款、扫描噪点、脚注里的例外。开源与闭源的差距在这里被放大到 2 到 3 倍(DS 17.2、GLM 11.2)。提醒两点:只有 100 题,方差很大;而且图中排序有误(Opus 38.6 最高却排第三),只看量级,别看名次。
ChartoGraphy|98.2 ★★ 链接到标题
考什么:专业领域的图表理解——医学、工程、金融、制造里的非标准图表格式,由天天看这类图的人出题,三位专家交叉验证。
差距在哪:图上 Kimi 98.2、GPT-6 Astra 91.0、Opus 89.0、DS 83.0。
但这项的数字我不建议引用。 论文原文是:三十个前沿配置里最好的只有 45.0% 的 pass@1,其余在 9.0 到 39.5% 之间。98.2 与 45% 差了一倍多,说明"带工具"版不是同一口径(大概率是 rubric 部分分,或工具能直接读到图表底层数据)。论文还指出失败集中在视觉感知:稀疏坐标轴的读数、投影 3D 几何、行业惯例——这些恰恰是工具救不了的部分。
ZeroBench|63.0 ★ 链接到标题
考什么:“看似不可能"的视觉题集,不给工具时模型几乎全 0 分。带工具考的是会不会用裁剪、放大、写代码把题救回来。
差距在哪:Kimi 63.0、Opus 61.0、Fable 59.0、GPT-6 Astra 58.0、DS 51.0。
pass@5 是五次取最好,天然虚高;不能读成"单次成功率 63%”。也正因为考的是"工具自救"这种通用技巧,几家差距被压缩到 12 分以内,区分度其实不高。
四、知识与职业任务:差距在"会不会交付" 链接到标题
HLE Full|78.0 ★★ 链接到标题
考什么:Humanity’s Last Exam 全量 2500 道专家级跨学科难题,允许使用工具和检索。
差距在哪:Kimi 78.0、Opus 67.7、Fable 65.6、GLM 62.5、DS 58.8、GPT-6 Astra 57.2。
带工具 + 可检索之后,这项考的其实是"知不知道自己不知道,以及会不会去查"。78 分意味着它已接近饱和,剩下 22 分多半是题目本身有争议或检索不到。另外 GLM 62.5 反超 DS 58.8,说明智谱的知识面不差。
GDPval-AA|1846 Elo ★★★★ 链接到标题
考什么:OpenAI GDPval 的真实职业交付物——数十个职业的实际工作产出,由专家按 rubric 评分。“AA"是 Artificial Analysis 的实现版本,分数是 Elo 尺度。
差距在哪:Opus 1866、Kimi 1846、Fable 1754、DS 1746、GLM 1650、GPT-6 Astra 1573。
Kimi 与 Opus 的 20 Elo 在噪声范围内,只能读成"同一档”。真正有信息的是 DS 与 GLM 差 96 Elo:在"做出一份像样的交付物"这件事上,DeepSeek 明显更靠谱,GLM 则更擅长答对题、不擅长交付。
Frontier Finance|58.6 ★★★ 链接到标题
考什么:官方 finance agent v2 harness,跑完整投资工作流:筛选标的、建模、盈利分析。
差距在哪:Fable 60.8、Kimi 58.6、GLM 57.5、Opus 56.7、DS 54.5、GPT-6 Astra 45.0。
前四名挤在 4 分之内,就是"同档"。GLM 反超 Opus 说明金融工作流不太吃通用智力,更吃领域模板和表格操作熟练度。这是 Kimi 对开源优势最小的一项(对 GLM 仅 +1.1)。GPT-6 Astra 的 45.0 更像 harness 不适配,而不是真实能力。
差距到底从哪来 链接到标题
把 14 项放在一起看,差距基本来自三种东西,而不是"模型聪明程度":
- 长程自我验证。Terminal-Bench、SWE Marathon 上,Kimi 靠 RL 学会了"宣布完成前先自检",这是它领先开源 20 分的主因;一旦任务变短(Agents’ Last Exam),优势立刻缩到 5 分。
- 领域环境与 reward。TB Science、OSWorld、GDP.pdf 考的是科学沙箱、GUI 轨迹、扫描件——这些数据闭源有、开源缺,所以开源在这三项集体落后 10 到 30 分,且差距与模型大小关系不大。
- 交付形态。GDPval 与 Frontier Finance 考"能不能交出可用产物",前四名挤在一起,说明这块靠的是产品化打磨,不是继续堆预训练。
三个数收尾 链接到标题
- 65.7(TB4,DS 42.3)→ 编码 agent 第一梯队,对开源是代差。
- 58.6(Frontier Finance,GLM 57.5、DS 54.5)→ 金融工作流只是"同档略优",别被营销话术带跑。
- 79.6(OSWorld,DS 69.3)→ 还不能当"替你操作电脑"的 agent 用。
选型上记一句:长程编码和专业文档选 Kimi,金融与知识面看 GLM,极致性价比看 DS 的 Flash 系列,GUI 与科研场景三家都还要谨慎。
口径说明:分数取自 Kimi K3.1 Pro 官方博客(2026-10-23)的总览图与脚注;GDP.pdf、Chartography 的题面设定参考 arXiv:2607.11192、arXiv:2608.10677。DS 为轻量版,故"领先 DS"偏乐观;图中 GDP.pdf 一格排序有误(Opus 38.6 最高却排第三),本文以其数值为准。